让 AI 只有七秒记忆:谷歌开源 AI 插件「大象与金鱼」
如果你被 Claude 封过号,那么当你看到封号提示的时候,往往会一脸懵逼,十分无奈,极端痛苦。我们丢失 Claude 账号,最怕的并不是不方便,也不是搞不了小号,而是我们积累的上下文和记忆被彻底抹去了。
和人一样,记忆被移除,对于一个持续做事的 AI 来说可以说是灭顶之灾,后续一切又得重新来过。
但记忆也不是越多越好。就像我们人有时候也希望自己放弃固有观点——比如我们审查自己的稿件,肯定希望能以完全陌生人的眼光来挑刺,但很遗憾,作者本人通常很难做到。AI 同样会充分利用你的历史上下文为你工作,所以有时候,我们反而需要 AI 忘记过去,以全新视角来审查我们的方案和文章。
最近 Google 开源的一个插件 Elephant-Goldfish Model(大象金鱼模型,简称 EGM),提供了一种很有意思的解决思路。项目地址:https://github.com/google/elephant-goldfish-model。
一只大象,几条金鱼
大象金鱼模型(EGM)的名字很形象,也很好理解:
- 大象(Elephant):记忆力好,负责记住项目背景、研究目标、历史讨论和已经做出的各项决定。
- 金鱼(Goldfish):恰恰相反,它不参与之前的讨论,只负责审查最终提交的成果。
比如,我们让 Codex / AI 助手帮忙设计一个研究方案。Codex 作为“大象”,了解整个研究推进过程,最终形成一份研究设计文档。
文档完工后,我们希望审核这份文档,这个时候就需要引入独立的 AI 审查员:
- 理论审稿人:研究假设有没有充分的理论支持?
- 方法审稿人:研究设计是否合理?是否存在内生性问题?
- 统计审稿人:统计方法是否合适?结论是否超出了数据能够支持的范围?
这些审稿人就是“金鱼”。它们没有之前的对话记忆,不知道我们和 Codex 之前讨论过什么、做过哪些权衡妥协,但它们可以拿到研究方案正文、审稿标准以及必要的参考资料,从一个全新的角度进行严格审查。
当然,生物学上真正的金鱼记忆力远不止七秒,这里的“金鱼”只是用来形容一个不继承历史对话与预设偏见的 AI。
这就是 EGM 最核心的思想:让了解背景的 AI 负责创造,让不了解讨论历史的 AI 负责质疑。
但质疑也不能胡乱质疑。金鱼提出的疑问最终还要回到大象这里,大象根据自己掌握的完整信息,使用证据来反驳金鱼;如果反驳不了,那可能真被抓到了漏洞,这时就需要进一步修改方案,或者把问题交给你(人类研究者)做最后的决定。
EGM 目前内置的审查流程主要针对软件设计文档,但我们可以完全把这套思路迁移到学术方案设计和论文初稿的审查中。
为什么要故意不给 AI 上下文?
过去,我们一直在努力解决 AI 的上下文问题:上下文窗口要更长、记忆要更完整,最好 AI 能记住我们过去所有的讨论。
EGM 提出了一个反过来的思路:有些时候,让 AI 不知道之前发生了什么,反而更有价值。
我们举个例子:假设你正在研究“数字技术使用对农村老年人生活满意度的影响”。你和 AI 讨论了很久,最后决定使用 OLS 回归。这个选择在当时可能有很多现实理由:数据限制、变量特点、现有同类文献的做法等。
如果让同一个 AI 审查方案,它往往会顺着之前的思路,继续帮你修补和完善 OLS 模型。
但如果换一个全新的 AI 会话,只把最终的研究方案交给它,它可能会直接问:
「为什么使用 OLS?如何处理潜在的内生性问题?」
这并不意味着 OLS 一定不合适,而是这个问题值得被重新审视。
在 EGM 中,这种审查是通过 Subagent(子智能体) 实现的。Subagent 是由主 Agent 启动的一个独立子任务会话。它可以使用相同的模型,但不继承主 Agent 的历史对话,只读取指定的任务、文档和参考资料。
审稿人提了意见,谁来决定是否修改?
EGM 不只是启动几个 AI 审稿人,它还设计了一套规范的审查意见处理机制。
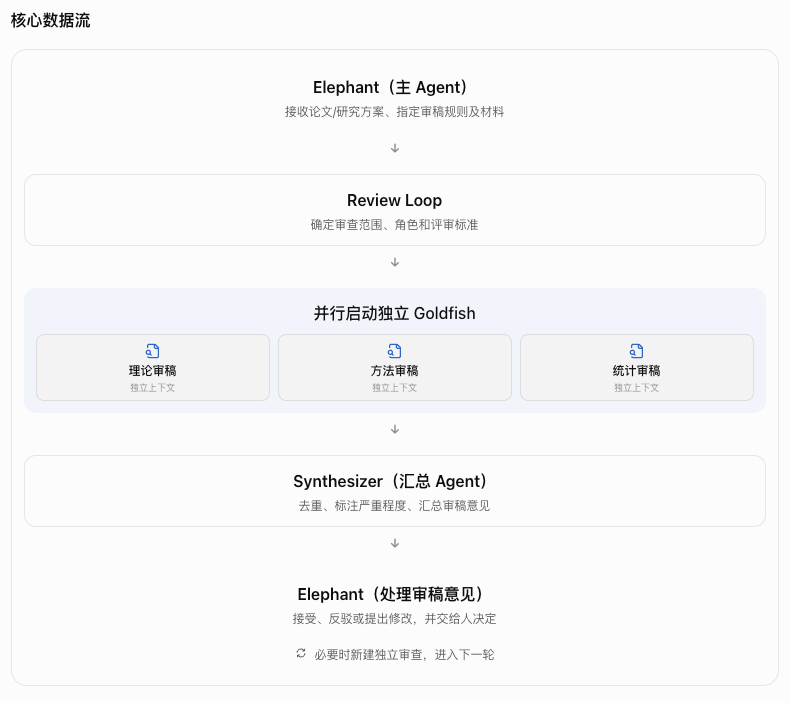
在这个闭环中:
- 审稿人(金鱼)提出问题:标记问题的严重程度,指出具体问题位置,并解释为什么认为这是一个缺陷;
- 作者(大象)逐条判断:
- 可以接受意见,提出具体的修改方案;
- 也可以提供证据反驳,说明审稿人的质疑不成立(例如论据已在附录或前提假设中明确);
- 人类仲裁:如果问题涉及审稿人无法获知的信息、或者大象与金鱼产生分歧,则交由人类研究者做最终裁决。
这一点在科研中非常重要:审稿人的意见并不天然正确,即使审稿人是一个独立的 AI。
比如,审稿人认为某个模型没有控制年龄因素,而实际上年龄已经包含在复合控制变量中。这种情况下,作者应该指出对应的变量定义和统计说明,而不是为了盲目迎合审稿人而胡乱修改模型。
实际上,我们可能早就在使用 EGM 了
看到这里,你可能会发现,这套方法并不神秘。
假如我们平时使用 Codex 写代码,然后打开 Cursor 让它独立审查;接着又把 Cursor 的意见交回 Codex,修改之后再让 Cursor 检查一次——这其实就是一个手工版的 Elephant-Goldfish Model。
科研中也是完全一样的:
我们可以在一个 AI 对话窗口中深入讨论研究方案,等方案成型后,再开一个全新的空白窗口,把方案发给另一个独立的 AI 进行挑刺式审查。两者的原理没有本质区别。
EGM 的主要价值,是把这些原本需要手工复制粘贴的操作标准化与自动化:它可以根据 Markdown 文件定义不同的审稿角色和审查标准,自动调用多个独立 Subagent,汇总审查意见,再通过固定流程交回给主 Agent 处理。
如果想在命令行中尝试体验,可以在 Codex CLI 中安装:
codex plugin marketplace add google/elephant-goldfish-model
codex plugin add egm@egm
安装后重新开启会话,选择相应的 EGM Skill,就可以用自然语言发起审查。
比插件更重要的,是这种工作方法
EGM 最有价值的地方,未必是它实现了多少自动化功能,而是它提醒了我们:AI 不应该只有一个角色。
过去我们使用 AI,往往希望它尽可能了解自己:我们提供背景、解释想法、反复讨论,让 AI 越来越理解我们的意图。
但当一项研究阶段性完成之后,也许应该主动切换另一种工作方式:让一个完全没有参与讨论的 AI,重新检查我们的结论。让它不必照顾之前的妥协,也不需要为自己曾经提出的建议辩护。
尤其是科研工作,理论是否成立、方法是否合理、证据是否充分,都值得接受独立的质疑。
EGM 插件并不是非装不可。你完全可以用两个独立的 AI 会话,手动实现最纯粹的版本:
- 一个负责创造,理解你的全部思路;
- 另一个负责审查,只评价你最终拿出来的成果。
对科研人员来说,这或许是比掌握某个插件更值得养成的习惯:不要只让 AI 帮你证明自己是对的,也要让 AI 认真寻找你可能错在哪里。